İki Kategorik Değişkenli Veriler Nedir? Çapraz Tablolarda Göreli Frekanslar Nasıl Hesaplanır?
Paydası Değişen Bir Oran Neden Bambaşka Bir Şey Söyler?


- Özgün
- İstatistik
İki kategorik değişkenli veriler, sayısal bir ölçüm ölçeğine dayanmayan iki ayrı nitel özelliğin aynı araştırma birimleri üzerinde sınıflandırılarak satır ve sütunlarda birlikte özetlendiği veri yapılarıdır.[1], [12] Bu yaklaşımın tarihsel temeli Karl Pearson'ın 1904 tarihli olumsallık çalışmasına uzanmaktadır. Çapraz tabloda her gözlem iki özelliğin kesiştiği hücreye yerleştirilmekte ve ortaya çıkan sayılar ortak, marjinal veya koşullu oranlara dönüştürülerek değişkenler arasında bir bağımlılık bulunup bulunmadığı incelenmektedir.
Farklı büyüklükteki grupları sadece ham gözlem sayılarıyla karşılaştırmak ya da bir yüzdelik oranın paydasını gözden kaçırmak, gündelik hayatta sık karşılaştığımız istatistiksel yanılgılardandır. Örneğin kişilerin birinci, ikinci, üçüncü ve dördüncü sınıf olarak dört gruba ayrıldığı bir veri kümesinde dördüncü sınıftakilerin %81'i kredi kartı sahibidir, ancak tüm kart sahipleri içinde bu sınıfın oranı yaklaşık %32'de kalmaktadır.[7] Aynı hücre, farklı paydalarla iki ayrı gerçeği anlatmaktadır. Üstelik bir tabloda iki değişken arasında gerçek bir oran farkı yakalansa bile, bu bağımlılığın rastgele dalgalanmadan mı yoksa gizli bir üçüncü değişkenden mi kaynaklandığını ayırt etmek ayrı bir denetim gerektirmektedir.[9], [10], [11]
Kategorik Değişkenler ve Çapraz Tablonun Yapısı
Veriyi özetlemenin ilk adımı, incelenen özelliklerin türünü belirlemektir. Nitel veriler (İng: "qualitative data"), özelliklerin sınıflandırılması veya betimlenmesiyle elde edilmektedir ve bu veri türü için kategorik veri (İng: "categorical data") adı da yaygın olarak kullanılmaktadır. Öte yandan nicel veriler (İng: "quantitative data"), sayma ya da ölçme sonucunda üretilmektedir. Kategorik özellikler sayısal bir büyüklük taşımamaktadır. Dolayısıyla saç rengi veya kan grubu için aritmetik ortalama hesaplamak anlamlı değildir.
Kategorik sınıflandırmanın temelinde, araştırmada verinin toplandığı tekil deney veya inceleme birimi olan gözlem birimi (İng: "case") yer almaktadır. Aslında bir veri setindeki sayıların neyi saydığı ancak bu birime bakılarak anlaşılmaktadır. Birimler sınıflara ayrıldığında her sınıfta belirli sayıda birim birikmektedir. Bu sayıya frekans (İng: "frequency") adı verilmektedir. Frekans, belirli bir değerin veya kategorinin veri setinde kaç kez görüldüğünü anlatmaktadır.[2]
Tek bir nitel değişkeni saymak kolaydır. Ancak araştırmacılar çoğu zaman ölçülemeyen iki özelliğin birbiriyle ilişkili olup olmadığını merak etmektedir. Karl Pearson, 1904 yılında yayımlanan On the Theory of Contingency and its Relation to Association and Normal Correlation başlıklı çalışmasında olumsallık (İng: "contingency"), ilişkililik (İng: "association") ve normal korelasyon kavramlarını bir arada incelemiştir. Pearson'ın yaklaşımında nicel olarak ölçülemeyen iki özellik önce gruplara bölünmekte, gözlemler ise daha sonra satır ve sütunlardan oluşan tablo bölmelerine dağıtılmaktadır. Böylece araştırmacılar, özellikleri sınıflandırmadan önce bir ölçüm ölçeği belirleme zorunluluğundan kurtulmaktadır.
İki nitel özelliği aynı anda özetleyen ve verileri iki ayrı sınıflandırma ölçütüne göre satırlar ve sütunlar yardımıyla tasnif eden bu dizilime çapraz tablo (İng: "contingency table") adı verilmektedir. Değişkenlerden birinde r, diğerinde c kategori bulunuyorsa tabloda hücre yer almaktadır. Yani her hücre, iki değişkene ait olası bir kategori birleşimini temsil etmektedir.
Tablonun sağ ve alt kenarlarındaki toplamlar ise değişkenlerin tekil dağılımlarını izlemeye olanak tanımaktadır. Satır toplamı, ilgili kategorinin bütün sütunlara dağılan gözlem sayısını vermektedir. Örneğin girişimcilik düzeylerini gösteren bir tablonun Kuzeydoğu (Northeast) satırında düşük girişimcilik için 300, yüksek girişimcilik için 460 gözlem bulunmaktadır. Bu satırın toplamı 760'tır. Alt kenardaki toplam satırında düşük girişimcilik sütunu için 549, yüksek girişimcilik sütunu için 555 sayısı yer almakta, sağ alt köşedeki son hücre ise bütün gözlemleri kapsayan 1104 genel toplamını göstermektedir.[4]
Kenarlardaki bu toplamlar hesaplamaları kolaylaştırmaktadır. Ancak toplamların yazıldığı ek satır ve ek sütun, tablonun kategori sayısını belirten boyut hesabına katılmamaktadır. Bu nedenle iki kategorili iki değişkeni çaprazlayan bir tablo, kenarlarına toplam satırı ve sütunu eklense bile 2'ye 2'lik bir tablo olarak sayılmaktadır.
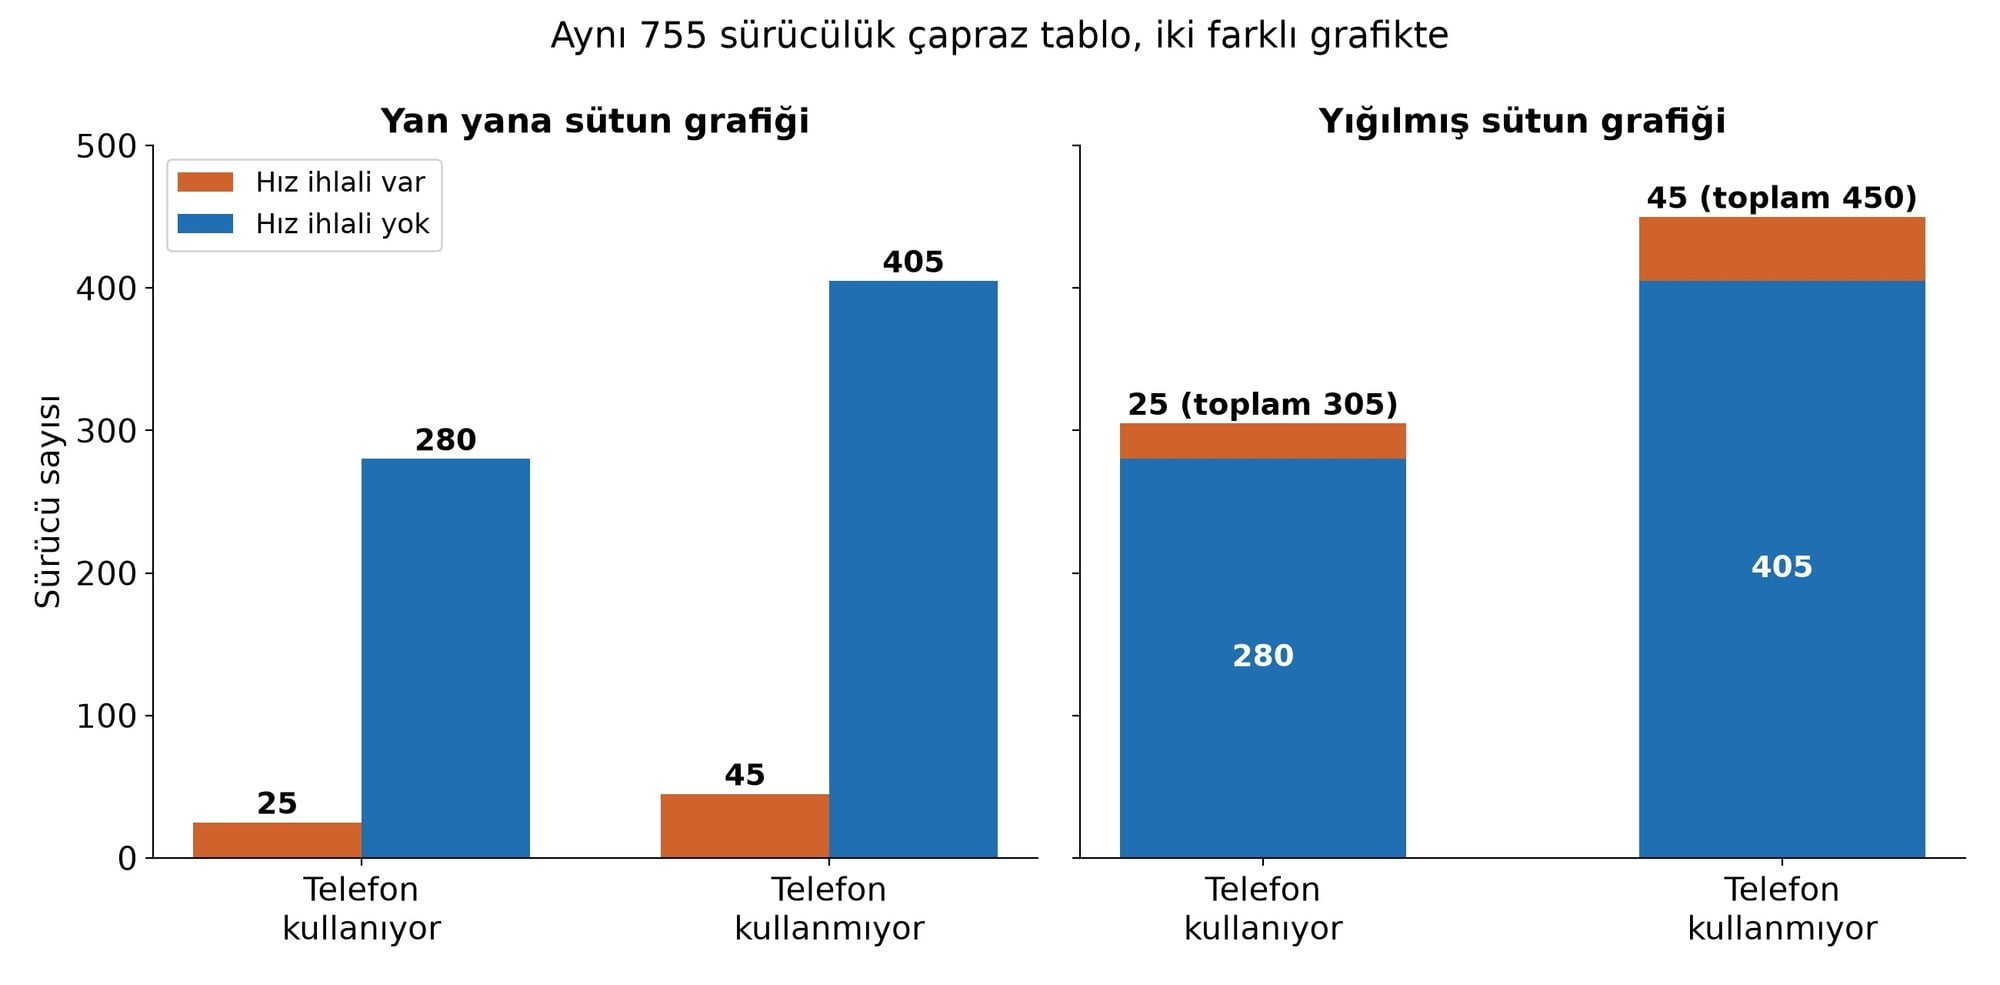
Çapraz tablodaki sayılar iki tür sütun grafiğiyle görselleştirilebilmektedir.[8] Bunlardan ilki olan yan yana sütun grafiği (İng: "clustered bar chart"), her kategori birleşimini ayrı bir sütunla göstermektedir. Yani bu grafikteki her sütun, çapraz tablonun tek bir hücresine karşılık gelmektedir. Yığılmış sütun grafiğinde (İng: "stacked bar chart") ise birinci değişkenin kategorileri ana sütunlar halinde dizilmekte, ikinci değişken de aynı sütunların içindeki alt bölümlerle temsil edilmektedir.
Çapraz Tabloda Göreli Frekanslar
Farklı büyüklükteki grupları ham frekanslarla karşılaştırmak yanıltıcıdır. Bu nedenle çapraz tablodaki sayılar standart oranlara dönüştürülmektedir. Göreli frekans (İng: "relative frequency") hesaplanırken ilgili frekans örneklemdeki toplam gözlem sayısına bölünmekte, elde edilen değer de kesir, ondalık sayı veya yüzde biçiminde yazılabilmektedir. Bütün olası değerleri kapsayan göreli frekans sütununun toplamı 1'dir.[2]
- Sigarayı Neden Bırakmalısınız: Sigara İçenlerin Akciğer Kanserine Yakalanma ve Erken Ölüm Olasılıkları Nasıl Değişir?
- Kulaklıklarınızın Sürekli Birbirine Dolanması ve Düğümlenmesinin Bilimsel Nedeni Ne?
- Koronavirüs Epidemiyolojisi ve Salgının Geleceğine Yönelik Modeller: COVID-19 Salgınından Neler Öğrendik?
Oran hesaplamaları birkaç adımdan oluştuğunda ara işlemleri yuvarlamak yerine sadece son sonucu yuvarlamak önerilmektedir. Ayrıca ondalık veya kesirli bir oran yüzdeye çevrilirken %100 ile çarpılmaktadır. Çapraz tablolarda payın bir hücre ya da kenar toplamı, paydanın da genel toplam ya da kenar toplamı olmasına göre üç ayrı göreli frekans türü ortaya çıkmaktadır. Bunlar ortak, marjinal ve koşullu göreli frekanslardır.
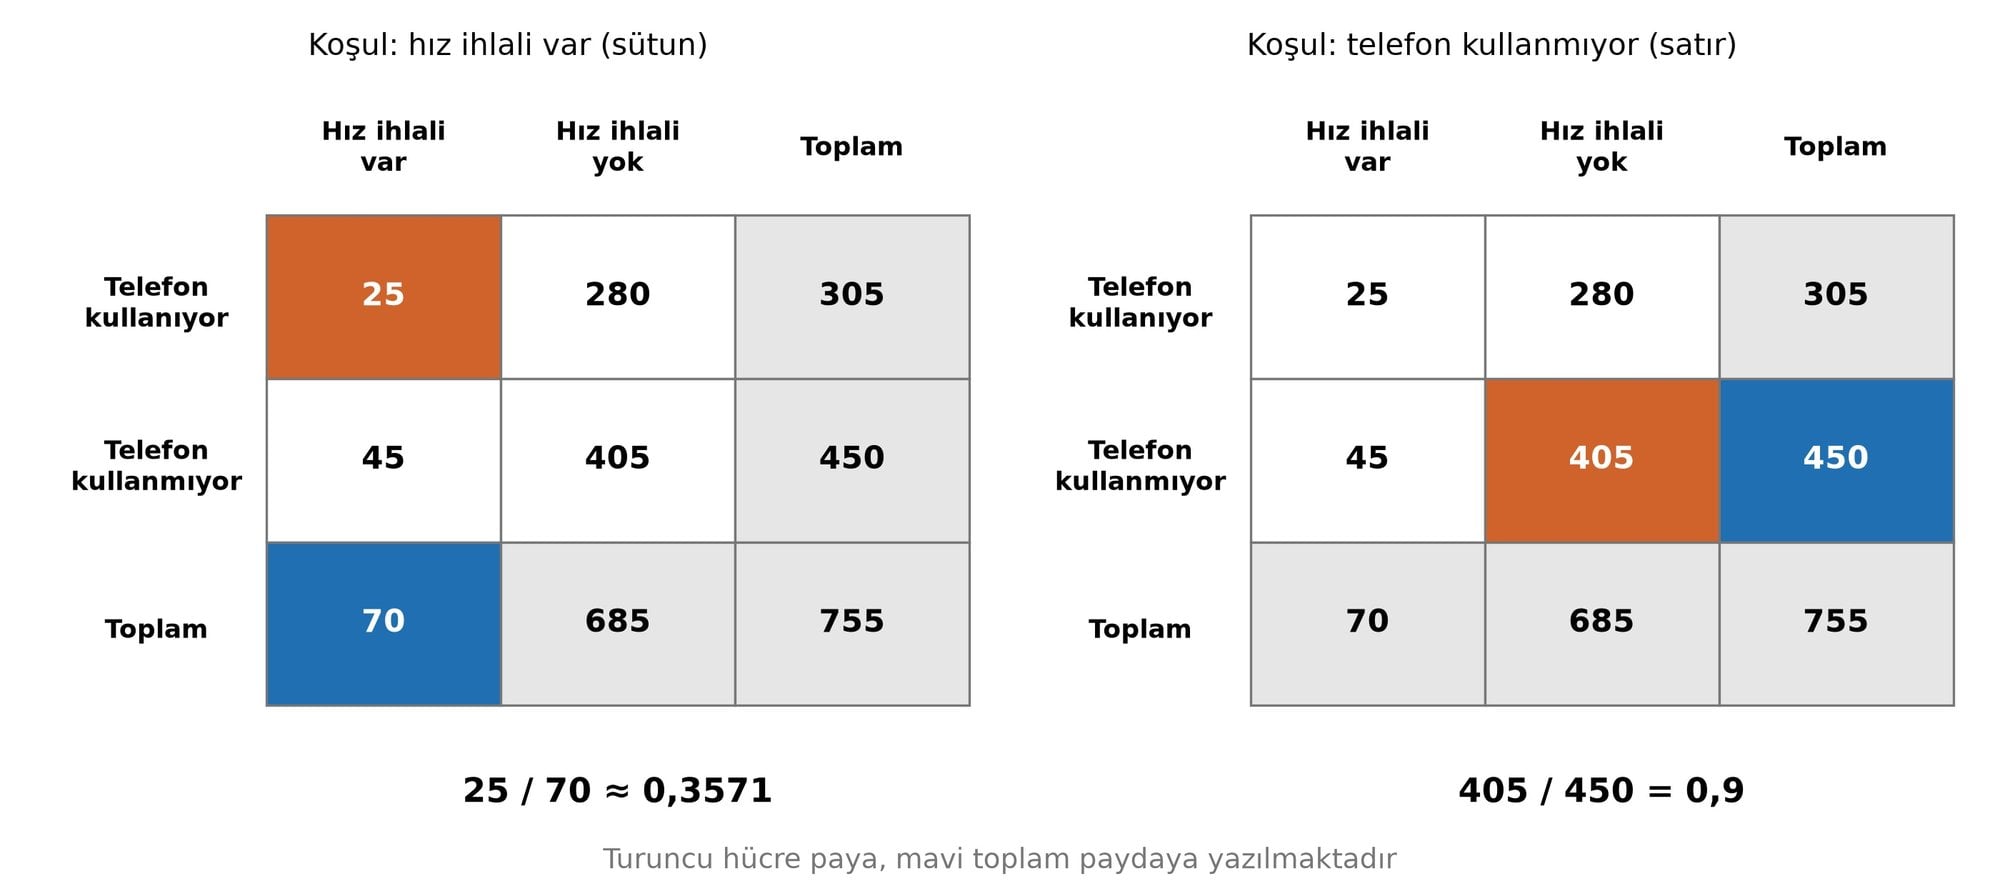
Bu üç türün nasıl hesaplandığını görmek için, araç kullanırken cep telefonu kullanma alışkanlığı ile son bir yıldaki hız ihlali kayıtlarını çaprazlayan 755 kişilik bir sürücü veri seti incelenebilir. Ancak bu tablo kavramları göstermek amacıyla kurgulanmıştır ve gerçek bir araştırmanın ölçülmüş bulgusu gibi sunulmamalıdır. Telefon kullanan sürücüler arasında hız ihlali bulunan 25, bulunmayan 280 kişi vardır ve satır toplamı 305'tir. Telefon kullanmayanlarda ise hız ihlali bulunan 45, bulunmayan 405 kişi sayılmaktadır. Bu satırın toplamı 450'dir. Hız ihlali bulunanların sütun toplamı 70, bulunmayanlarınki 685 ve genel toplam 755'tir. Nitekim satır toplamları da 305 + 450 = 755 sonucunu vermektedir.
Ortak ve Marjinal Göreli Frekanslar
Bütün örneklemi payda alan iki temel oran türü bulunmaktadır. Birincisi olan ortak göreli frekans (İng: "joint relative frequency"), iki kategoriye aynı anda ait bir hücredeki gözlem sayısının bütün gözlemlere oranıdır. Genel gösterimde 'inci satır ve 'inci sütundaki hücrenin gözlem sayısı , genel toplam olduğunda bu oran şu denklemle hesaplanmaktadır:
Öte yandan ikinci tür olan marjinal göreli frekans (İng: "marginal relative frequency"), kenar toplamlarının genel toplama oranlanmasıyla bulunmaktadır. Satır toplamı ve sütun toplamı olmak üzere marjinal satır oranı , marjinal sütun oranı ise biçiminde elde edilmektedir.
Çözümlü örnek 1: Telefon kullanan sürücülerin marjinal ve ortak göreli frekansları kaçtır?
Verilenler: Telefon kullananların satır toplamı 305, telefon kullanıp hız ihlali bulunmayanların hücresi 280 ve genel toplam 755.
İstenen: Telefon kullanan sürücülerin marjinal göreli frekansı ile hem telefon kullanan hem de hız ihlali bulunmayan sürücülerin ortak göreli frekansı.
1. adım: Marjinal oranda hız ihlali ayrımına bakılmadığı için birinci satırın toplamı olan 305, genel toplam olan 755'e bölünmektedir:
2. adım: Ortak oranda ise tablonun iç kısmına bakılmakta, sadece iki kategorinin kesiştiği hücredeki 280 gözlem paya yazılmakta ve payda yine 755 olmaktadır:
Sonuç: Telefon kullananların marjinal göreli frekansı yaklaşık 0,4040, ortak göreli frekans ise yaklaşık 0,3709'dur. İki işlemde de payda sabit kalmaktadır. Fakat marjinal oranda kenar toplamı (305), ortak oranda ise tek bir hücre (280) bölündüğü için sonuç 0,4040'tan 0,3709'a düşmektedir.[5]
Koşullu Göreli Frekans ve Koşulun Yönü
Araştırmacılar çoğu zaman bütün örneklemin ne kadarının bir hücreye düştüğünü değil, belirli bir alt grup içinde diğer özelliğin nasıl dağıldığını öğrenmek istemektedir. Bu durumda hesaplanan koşullu göreli frekans (İng: "conditional relative frequency"), satıra göre ele alındığında hücre sayısının ilgili satırın kenar toplamına bölünmesiyle bulunmaktadır. Örneğin birinci satırın birinci sütunundaki hücre için bu oran şu eşitlikle gösterilmektedir:
Belirli bir satıra koşullanan dağılımda bütün koşullu göreli frekansların toplamı 1'dir, yani eşitliği sağlanmaktadır.
Çözümlü örnek 2: Sürücü tablosunda iki yöndeki koşullu oranlar kaçtır?
Verilenler: 70 kişilik hız ihlalli sütun ile bu sütunun telefon kullananlara ait 25 kişilik hücresi. Ayrıca telefon kullanmayanların 450 kişilik satırı ile bu satırdaki 405 ihlalsiz sürücü.
İstenen: Hız ihlali bulunduğu bilinen bir kişinin telefon kullanmış olma oranı ile telefon kullanmadığı bilinen bir kişinin hız ihlali bulunmama oranı.
1. adım: İlk soruda koşul sütunda yer aldığından payda 755 değil, koşulu sağlayan sütunun 70 kişilik toplamıdır ve hücredeki 25 bu toplama bölünmektedir:
2. adım: İkinci soruda ise koşul satırda yer aldığından payda 450 olmaktadır:
Sonuç: Hız ihlali bulunanlarda telefon kullanma oranı yaklaşık 0,3571, telefon kullanmayanlarda hız ihlali bulunmama oranı ise 0,9'dur.[6]
Koşullu oranlarda sık düşülen bir yanılgı, ön koşul ile aranan sonucu birbirinin yerine geçirerek paydayı değiştirmektir. Bu hatanın etkisi, dört sınıftaki kişilerin kredi kartı sahipliği verisinde görülebilir. Birinci, ikinci, üçüncü ve dördüncü sınıflarda kart sahibi olanların sayıları sırasıyla 42, 55, 76 ve 81'dir. Kart sahiplerinin toplamı 254'tür. Benzer şekilde kart sahibi olmayanların aynı sınıflara göre sayıları 58, 45, 24 ve 19 olup toplamları 146'dır.
Çözümlü örnek 3: Koşul tersine çevrilince dördüncü sınıfın oranı nasıl değişir?
Verilenler: Dördüncü sınıfta kart sahibi 81 ve kart sahibi olmayan 19 kişi ile kart sahiplerinin 254 kişilik toplamı.
İstenen: Dördüncü sınıf içinde kart sahibi olanların koşullu yüzdesi ve kart sahipleri içinde dördüncü sınıfta bulunanların yüzdesi.
1. adım: Ön koşul dördüncü sınıfta bulunmak olduğundan kart sahibi 81 ile kart sahibi olmayan 19 kişi toplanmakta, paydaya da 100 kişilik grup büyüklüğü yazılmaktadır:
2. adım: Koşul tersine çevrildiğinde kart sahipleri içinde dördüncü sınıfta bulunanların oranı sorulmakta ve payda kart sahiplerinin toplamı olan 254'e dönüşmektedir:
Sonuç: Aynı hücredeki 81 sayısı, dördüncü sınıf içinde %81, kart sahipleri içinde ise yaklaşık %32 oranına karşılık gelmektedir.[7] Kısacası koşul tersine çevrilince hem payda hem de yanıt değişmektedir.
Koşullu Dağılımları Karşılaştırarak İlişkililik ve Bağımsızlık Kararı Vermek
Koşullu oranların nasıl hesaplandığı anlaşıldığında, çapraz tablonun asıl amacına, yani iki nitel özellik arasında bir bağ bulunup bulunmadığını anlamaya geçilebilir. Bunun için önce istatistiksel bağımsızlık (İng: "statistical independence") kavramını tanımlamak gerekmektedir. Bağımsız olaylar, birbirleriyle ilişkisiz olaylardır. Bağımsızlık durumunda bir B olayının gerçekleştiğinin bilinmesi A olayının olasılığını değiştirmemektedir. Koşullu dağılımları karşılaştırmanın dayanağını oluşturan bu özellik şu eşitlikle gösterilmektedir:
Benzer şekilde Pearson'ın 1904 tarihli açıklamasında iki olayın bağımsız olması, birlikte gerçekleşme olasılığının ayrı olasılıklarının çarpımına () eşit olması demektir. Bağımsızlık kavramı, ayrık olaylar (İng: "disjoint events") kavramından farklıdır. Ayrık iki olayın aynı anda gerçekleşmesi olanaksızdır. Bu yüzden olasılıkları sıfırdan büyük iki ayrık olaydan birinin gerçekleşmesi, diğerinin olasılığını sıfıra indirmektedir ve bu iki olayın bağımsız olması mümkün değildir.
Bağımlılık tabloda nasıl bir örüntü bırakmaktadır? Bir değişkenin kategori oranları diğer değişkenin sınıflarına göre değişiyorsa bu iki sınıflandırma bağımlı görünmektedir (İng: "dependent"). Buna göre iki kategorik değişken arasındaki ilişkililik, grupların kategori oranları karşılaştırılarak değerlendirilmektedir.
Bu yöntemi C vitamini (askorbik asit) kullanımı ile soğuk algınlığı arasındaki ilişkiyi inceleyen 279 kişilik bir araştırmada görmek mümkündür. Tablonun sütunları soğuk algınlığı geçiren ve geçirmeyen kişileri göstermektedir. Plasebo (etkisiz madde) satırında 31 kişi soğuk algınlığı geçirmiş, 109 kişi geçirmemiştir ve satır toplamı 140'tır. Askorbik asit satırında ise 17 kişi hastalanmış, 122 kişi hastalanmamıştır ve toplam 139'dur. Sütun toplamları 48 ile 231, genel toplam ise 279'dur.
Çözümlü örnek 4: Plasebo ve C vitamini gruplarının hastalanma oranları nasıl karşılaştırılır?
Verilenler: 279 kişilik tablonun plasebo satırı (31 hastalanan, toplam 140 kişi) ve askorbik asit satırı (17 hastalanan, toplam 139 kişi).
İstenen: Plasebo grubunun marjinal göreli frekansı ve iki grubun koşullu hastalanma oranları.
1. adım: Marjinal oran ile koşullu oranın yanıtladığı soruları ayırmak için önce plasebo grubunun bütün örneklem içindeki marjinal göreli frekansı bulunmaktadır:
2. adım: Bu 0,502 değeri sadece kişilerin yaklaşık yarısının plasebo grubunda yer aldığını gösterdiği için hastalanma oranında paydaya bütün 279 kişi değil, plasebo satırının toplamı olan 140 yazılmaktadır:
3. adım: C vitamini grubu için aynı yöntemle koşullu oran hesaplanmakta ve bu değer, plasebo grubundaki 31 / 140 oranıyla doğrudan karşılaştırılabilecek aynı sonuca ait koşullu oranı vermektedir:
Sonuç: Plasebo grubunun marjinal oranı hastalanma oranından farklı bir soruyu yanıtladığı için karşılaştırma 140 / 279 ile değil, 31 / 140 (yaklaşık 0,221) ile 17 / 139 (yaklaşık 0,122) koşullu oranlarıyla yapılmaktadır. Bu iki oranın farklı olması ilişkililiğin bir işaretidir. Farkın şanstan doğup doğmadığı ise bir sonraki bölümde anlatılan ki-kare testiyle sınanmalıdır.
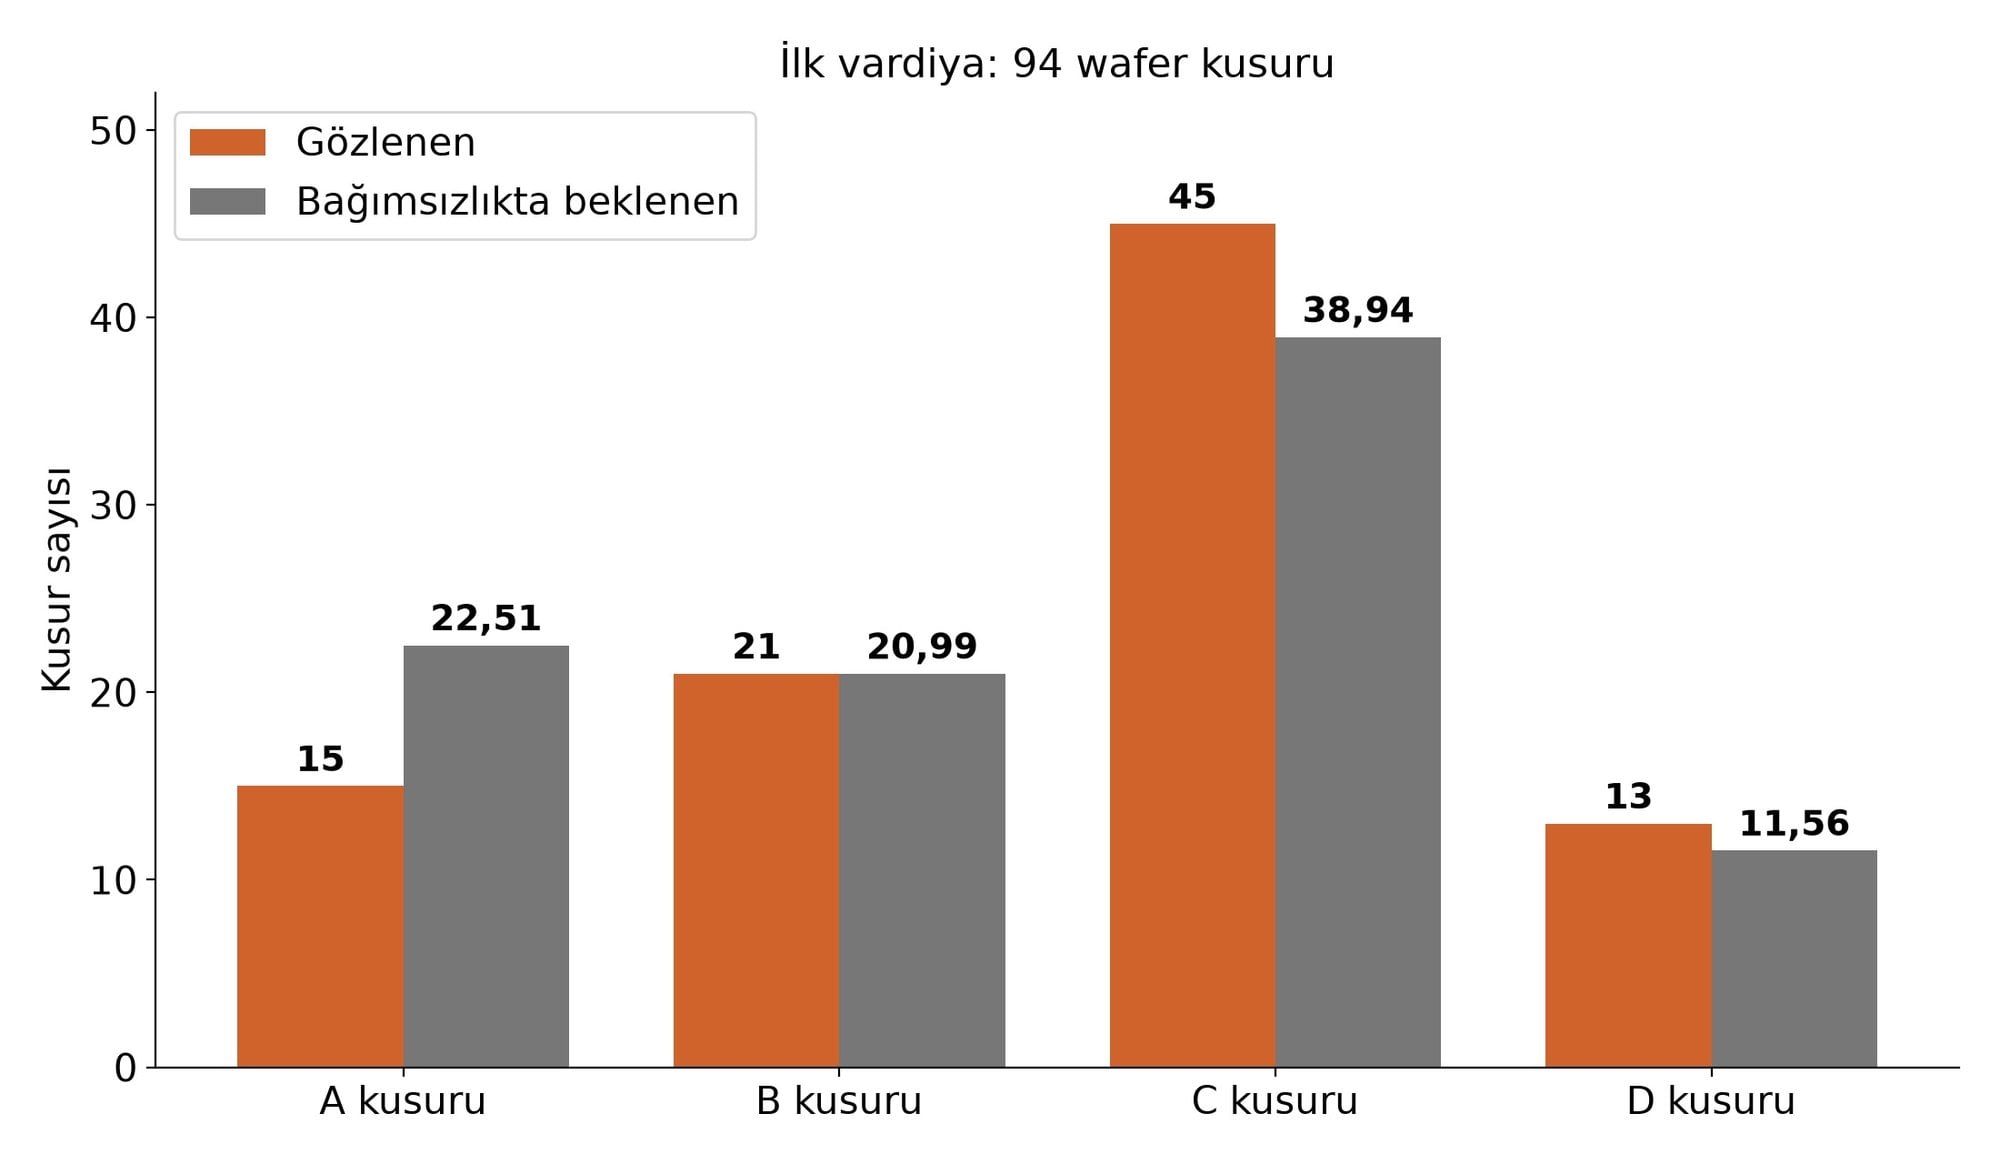
Koşullu oranların karşılaştırılması, ikiden fazla kategorili endüstriyel tablolarda da aynı kuralla çalışmaktadır. Örneğin yarı iletken plaka (İng: "wafer") üretiminde toplam 309 plaka kusuru kaydedilmiş ve kusur türleri (A, B, C, D) üretim vardiyalarıyla çapraz sınıflandırılmıştır. İlk vardiyada A, B, C ve D kusurlarının gözlenen sayıları sırasıyla 15, 21, 45 ve 13, satır toplamı ise 94'tür. Kenar toplamlarından hesaplanan paylar ise A kusuru için 309'da 74, ilk vardiya için 309'da 94'tür. A kusurunun ilk vardiyadaki payı şöyledir:
Bütün vardiyalardaki payı ise şöyledir:
Yani birinci vardiyada A türü hatanın payı, bütün vardiyalardaki paydan düşüktür.
Kusur türlerinin oranları vardiyadan vardiyaya değişiyorsa bu iki sınıflandırma bağımlı görünmektedir.[3]
Rastgele Örnekleme Değişkenliği, Beklenen Frekanslar ve Ki-Kare Testi
Koşullu oranlar arasında sayısal bir fark görmek, anakütlede iki değişkenin kesinlikle ilişkili olduğu anlamına mı gelmektedir? Anakütlede tam bir bağımsızlık bulunsa bile örneklemler rastgele örnekleme değişkenliği (İng: "random sampling variation") nedeniyle farklı sonuçlar verebilir, dolayısıyla tablodaki küçük oran farklarına bakarak anakütlede kesin bir ilişki ilan etmek geçerli değildir.
Farkın şanstan mı yoksa gerçek bir bağımlılıktan mı kaynaklandığını saptamak için Pearson'ın kullandığı temel ilkeye başvurulmaktadır. Pearson, gözlenen hücre frekansının bağımsızlık altında beklenen frekanstan ne kadar saptığını ölçüt olarak kullanmıştır ve böylece tarihsel olumsallık yaklaşımı, gözlenen ve beklenen hücre frekanslarının karşılaştırılmasına bağlanmaktadır. Bağımsızlık doğru olduğunda beklenen hücre frekansı (İng: "expected cell frequency"), satır toplamı ile sütun toplamının çarpımının genel toplama bölünmesiyle bulunmaktadır. Formül olarak şu biçimde yazılmaktadır:
Örneğin plaka tablosunun ilk vardiyasında gözlenen 15, 21, 45 ve 13 sayılarına karşılık beklenen frekanslar A için 22,51, B için 20,99, C için 38,94 ve D için 11,56'dır.[3]
Gözlenen ve beklenen frekanslar belirlendikten sonra bu iki küme ki-kare (İng: "chi-square") testiyle karşılaştırılmakta ve test istatistiği her hücredeki gözlenen ve beklenen frekans farkının karesini ilgili hücrenin beklenen frekansına bölmektedir. Bu değerler bütün satır ve sütunlar üzerinden toplandığında şu istatistik elde edilmektedir:
Yani gözlenen sayılar beklenen değerlerden uzaklaştıkça büyümekte ve bağımlılık yönündeki kanıt güçlenmektedir.
Bu başlangıç düzeyi testin güvenilir olması için belirli bir koşul gerekmektedir ve bu koşula göre beklenen hücre frekanslarının hepsi en az 5 olmalıdır. Aslında bu eşik gözlenen hücre sayılarına ilişkin değildir. Denetim, hesaplanan beklenen frekanslar üzerinden yapılmaktadır. Ayrıca ilişki için yeterli kanıt bulunamaması, iki değişkenin kesinlikle bağımsız olduğunun kanıtlandığı anlamına gelmemektedir.
Başkalarının Çapraz Tablolarını ve İstatistiksel Yorumlarını Eleştirel Okumak
Haberlerde, kamuoyu araştırmalarında veya raporlarda başkalarının oluşturduğu bir çapraz tabloyla karşılaşıldığında, aritmetiğin doğruluğu yorumun geçerliliğini tek başına garanti etmemektedir. İlk denetim ölçütü, ilişkililik ile nedensellik (İng: "causation") arasındaki ayrımdır. İki değişken arasında ilişki araştırılması, birinin diğerine neden olup olmadığının gösterilmesiyle aynı şey değildir.[4]
Nedensellik iddiasının gücü, araştırmanın tasarımına bağlıdır. Katılımcıların gruplara rastgele atama (İng: "randomization") yöntemiyle dağıtıldığı kontrollü deneylerde amaç, tedavi ve kontrol gruplarını uygulama dışında birbirine benzer tutmaktır. Öte yandan araştırmacının müdahale etmeden sadece mevcut durumu kaydettiği gözlemsel bir çalışmada (İng: "observational study") ilişki belirlenebilse bile nedenselliği ortaya koymak daha zordur.
Tabloda görünmeyen üçüncü değişkenler, gözlemsel çalışmalarda nedenselliği zorlaştıran etkenlerden biridir. Bu nedenle nedensel bir sonuç çıkarılmadan önce bu değişkenler mutlaka dikkate alınmalıdır. Karıştırıcı değişken (İng: "confounding variable"), hem açıklayıcı değişken hem de yanıt değişkeniyle ilişkili olan üçüncü değişkendir.
Üçüncü bir değişkenin gizli etkisi kimi zaman ilişkinin yönünü bile tersine çevirebilir. Başka bir deyişle iki değişkenli toplu tabloya bakarak verilen bir karar, alt gruplar incelendiğinde tam tersi bir sonuca dönüşebilir. Bu uyarı istatistikte Simpson paradoksu (İng: "Simpson's paradox") kapsamında ele alınmaktadır.
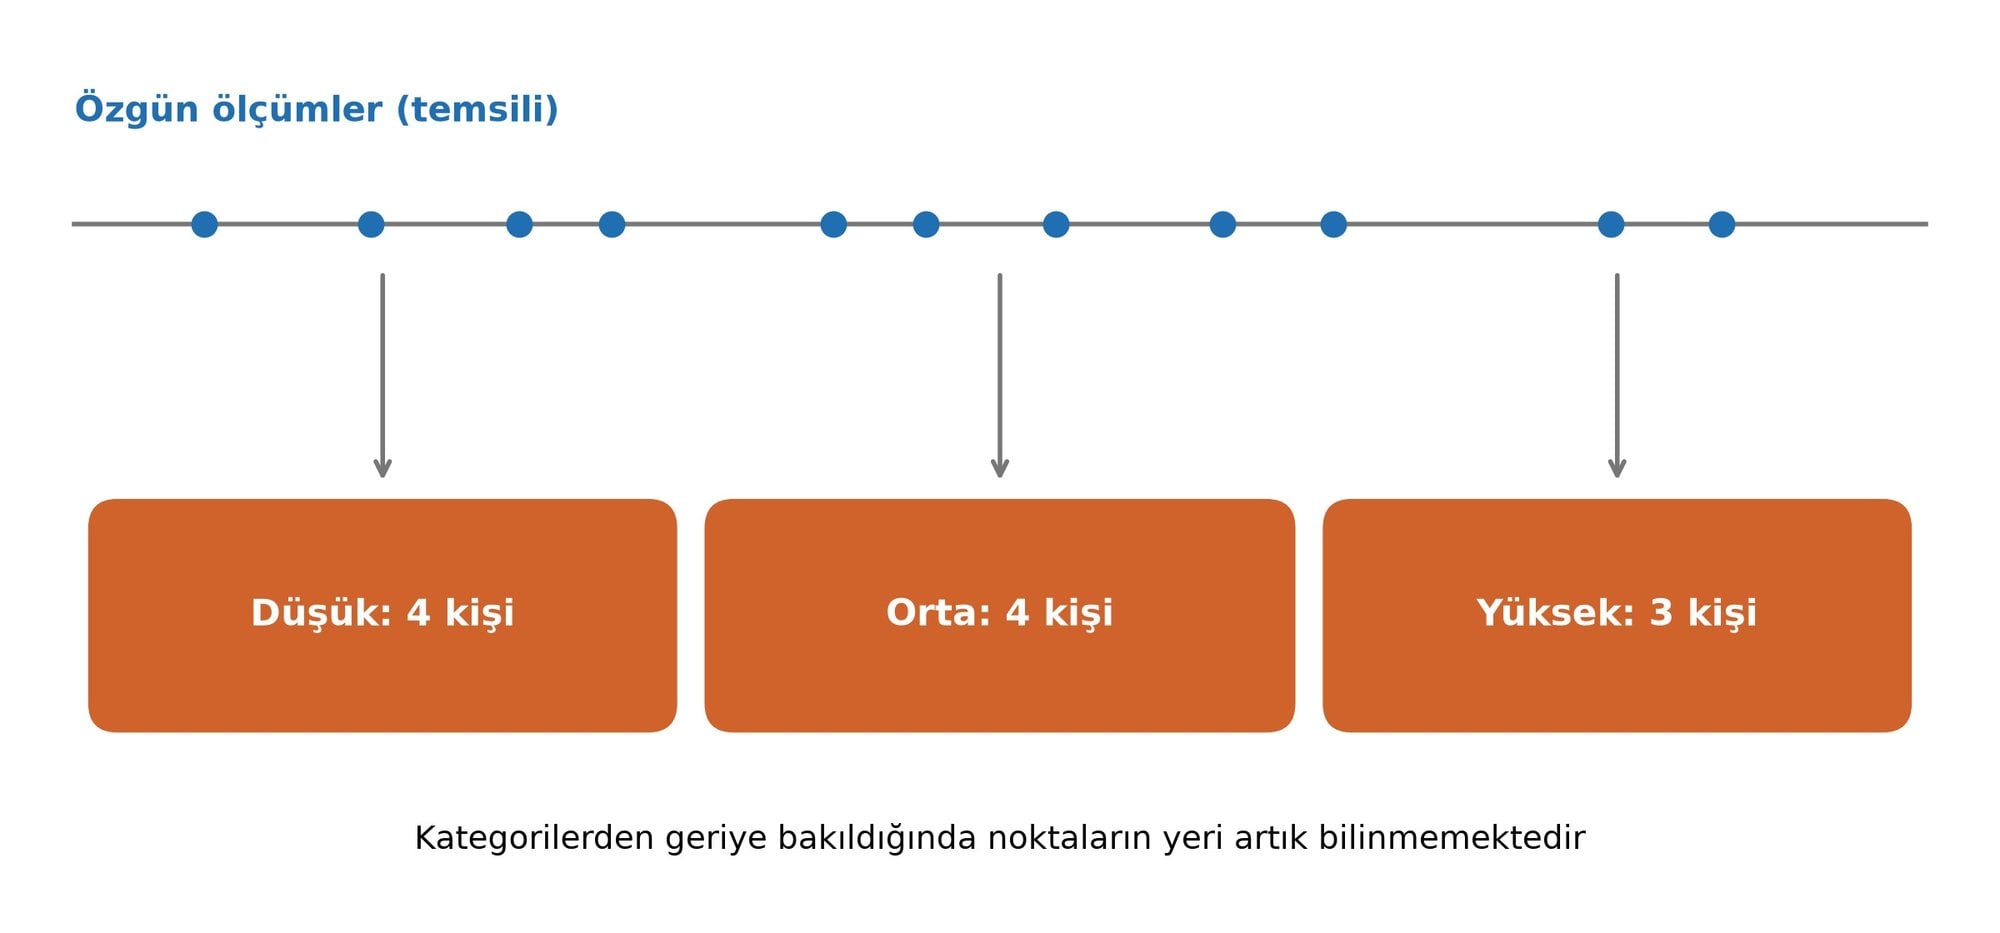
Verilerin sahada nasıl toplandığı ve sınıflandırıldığı da yorumların geçerliliğini belirlemektedir. Örnekleme yanlılığı (İng: "sampling bias"), örneklemi elde etmek için kullanılan yöntemden kaynaklanmaktadır ve bu yüzden bir başkasının tablosunu değerlendirirken katılımcıların nasıl seçildiği mutlaka sorgulanmalıdır. Benzer şekilde yanıt yanlılığı (İng: "response bias"), katılımcıların gerçeğe uygun yanıt vermemesiyle ortaya çıkabilir. Öyleyse düzgün hesaplanmış bir tablo, yanıtların doğruluğunu kendi başına sağlamamaktadır.[10] Son olarak nicel ölçümleri sonradan kategorilere ayırmak bilgi kaybına (İng: "loss of information") yol açmaktadır, çünkü sadece bu kategorilerden hareketle özgün ölçüm değerleri bir daha geri üretilememektedir.
Sonuç
İki kategorik değişkenli veriler, önceden sayısal bir ölçüm ölçeği gerektirmeyen nitel özelliklerin satır ve sütunlarda çapraz sınıflandırılmasıyla kurulan ve ortak, marjinal ile koşullu göreli frekanslar üzerinden iki sınıflandırma arasındaki ilişkililiği görünür kılan temel analiz araçlarıdır. Bu araçlarla C vitamini tablosundaki hastalanma sayılarından endüstriyel üretimdeki 309 plaka kusuruna kadar farklı büyüklükteki gruplar göreli frekanslarla karşılaştırılabilmektedir. Pearson'ın 1904 tarihli çalışması bu yaklaşımın tarihsel temelidir.[12]
Bununla birlikte 755 sürücülük hız ihlali örneğinin gösterdiği üzere, aynı veri kümesinden üretilen bir oranın anlamı tamamen paydaya hangi toplamın yazıldığına bağlıdır.[6] Koşulun yönünü tersine çevirmek, aynı hücreden %81 yerine yaklaşık %32 gibi farklı bir oran vermektedir. Örneklemde gözlenen oran farklarının rastgele örnekleme değişkenliğinden ayrılması için beklenen hücre frekanslarının ki-kare yaklaşımıyla sınanması gerekmektedir.[9]
Üstelik eksiksiz hesaplanmış bir çapraz tabloda istatistiksel bağımlılık saptansa bile, bu bulgu tek başına bir özelliğin diğerine neden olduğunu kanıtlamamaktadır. Sunulan yüzdelik iddiaların arkasındaki örnekleme ve yanıt yanlılıklarını, nicel verileri kategorileştirmenin doğurduğu bilgi kaybını, karıştırıcı değişkenleri ve Simpson paradoksunu sorgulamak, okuru başkalarının yorumlarını olduğu gibi kabul etmekten kurtarıp veriye dayalı kendi kararını verebilen bir gözlemciye dönüştürmektedir.
Bu makale üzerine konuşmaya devam et
Topluluk sohbetine katıl, yorum bırak veya ayrıntılı bir soru sor.
- Muhteşem!0
- Tebrikler!0
- Bilim Budur!0
- Mmm... Çok sapyoseksüel!0
- Güldürdü0
- İnanılmaz0
- Umut Verici!0
- Merak Uyandırıcı!0
- Üzücü!0
- Grrr... *@$#0
- İğrenç!0
- Korkutucu!0
- ^Illowsky, B. ve Dean, S.. 1.2 Data, Sampling, And Variation In Data And Sampling. Introductory Statistics 2E. Openstax, Rice University. (1 Ocak 2023). Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: OpenStax | Arşiv Bağlantısı
- ^abIllowsky, B. ve Dean, S.. 1.3 Frequency, Frequency Tables, And Levels Of Measurement. Introductory Statistics 2E. Openstax, Rice University. (1 Ocak 2023). Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: OpenStax | Arşiv Bağlantısı
- ^abNIST/SEMATECH. 7.4.5. How Can We Compare The Results Of Classifying According To Several Categories? E-Handbook Of Statistical Methods. National Institute Of Standards And Technology. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: NIST | Arşiv Bağlantısı
- ^abThe Pennsylvania State University, Department of Statistics. 6 Categorical Data Comparisons. Stat 800: Applied Research Methods. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^The Pennsylvania State University, Department of Statistics. 3 Two-Way Tables: Independence And Association. Stat 504: Analysis Of Discrete Data. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^abIllowsky, B. ve Dean, S.. 3.4 Contingency Tables. Statistics. Openstax, Rice University. (1 Ocak 2020). Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: OpenStax | Arşiv Bağlantısı
- ^abThe Pennsylvania State University, Department of Statistics. 6 Relationships Between Categorical Variables. Stat 100: Statistical Concepts And Reasoning. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^The Pennsylvania State University, Department of Statistics. 2 Describing Data, Part 1. Stat 200: Elementary Statistics. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^abThe Pennsylvania State University, Department of Statistics. 11 Chi-Square Tests. Stat 200: Elementary Statistics. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^abThe Pennsylvania State University, Department of Statistics. 1 Collecting Data. Stat 200: Elementary Statistics. Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Penn State Eberly College of Science | Arşiv Bağlantısı
- ^Adhikari, A., DeNero, J. ve Wagner, D.. 2.4 Randomization. Computational And Inferential Thinking: The Foundations Of Data Science. University Of California, Berkeley. (1 Ocak 2022). Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Computational and Inferential Thinking | Arşiv Bağlantısı
- ^abPearson, K.. Mathematical Contributions To The Theory Of Evolution. Xiii. On The Theory Of Contingency And Its Relation To Association And Normal Correlation. Drapers’ Company Research Memoirs, Biometric Series I, 1-35. Dulau And Co. (1 Ocak 1904). Alındığı Tarih: 3 Kasım 2026. Alındığı Yer: Internet Archive, Cornell University Library nüshası | Arşiv Bağlantısı
Evrim Ağacı'na her ay sadece 1 kahve ısmarlayarak destek olmak ister misin?
Şu iki siteden biriyle hemen destek olabilirsin:
kreosus.com/evrimagaci | patreon.com/evrimagaci
Çıktı Bilgisi: Bu sayfa, Evrim Ağacı yazdırma aracıyla 07.11.2026 09:38:41 tarihinde oluşturuldu. Evrim Ağacı'ndaki içerikleri birden fazla editör sürekli gözden geçiriyor, güncelliyor ve geliştiriyor. Bu çıktıdan sonraki güncellemeleri görmek ve içeriğin en güncel hâlini okumak için şu adrese git: evrimagaci.org/s/24102
İçerik Kullanım İzinleri: Evrim Ağacı'ndaki yazılı içerikler orijinallerine hiçbir şekilde dokunulmadığı sürece izin alınmaksızın paylaşılabilir, kopyalanabilir, yapıştırılabilir, çoğaltılabilir, basılabilir, dağıtılabilir, yayılabilir, alıntılanabilir. Ancak bu içeriklerin hiçbiri izin alınmaksızın değiştirilemez ve değiştirilmiş hâlleri Evrim Ağacı'na aitmiş gibi sunulamaz. Benzer şekilde, içeriklerin hiçbiri, söz konusu içeriğin açıkça belirtilmiş yazarlarından ve Evrim Ağacı'ndan başkasına aitmiş gibi sunulamaz.